¿Acabará la IA en una mochila?
23 de junio de 2026
Hace unas semanas, preparando una clase sobre inversión en tecnología, le pedí a un alumno que me calculara algo sencillo: si multiplicas por diez la inversión en entrenar un modelo de IA, ¿cuánto mejora el resultado? La respuesta intuitiva era "mucho". La respuesta real es entre uno y dos puntos porcentuales en los benchmarks estándar.
Conviene detenerse aquí. Porque no sé si ese dato cambia la conversación entera sobre la IA, pero sí la percepción que los lectores no profesionales tienen de ella. Así que vamos primero con unos datos que nos ayuden a poner las cosas en perspectiva.
En 2020, entrenar GPT-3 costó del orden de cinco millones de dólares. En 2023, GPT-4 rondó los ochenta millones en computación pura (y Sam Altman admitió que superó los cien si sumamos todos los conceptos). En 2025, Grok-4 le costó a xAI unos quinientos millones, según las estimaciones de Epoch AI. Es decir: el coste de construir lo que en el argot sectorial llamamos "modelos de frontera" se ha multiplicado por cien en los cinco años que la IA tardó en incorporarse al imaginario colectivo. Pero la mejora que tal esfuerzo inversor trajo consigo, en términos de lo que un modelo sabe hacer de verdad, ha pasado de saltos de decenas de puntos a pasitos de entre uno o dos. La curva de inversión es exponencial, pero la de mejora es asintótica. Y entre ambas se abre un hueco que ningún plan de negocio puede sostener indefinidamente.
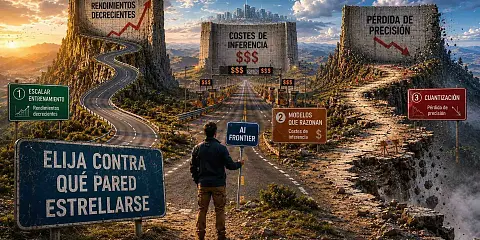
Es lo que Hemant Shukla documenta en su análisis del "Scaling wall of diminishing returns": multiplicar por diez la capacidad de cómputo compra ya solo uno o dos puntos porcentuales de mejora en los benchmarks estándar. Y no olvidemos que eso se produce sobre cantidades de inversión ya de por sí indecentes.
Es un primer muro, imposible de saltar en el estado actual de las cosas.
Pero... si razona mejor, se podrá cobrar más caro, ¿no?
La respuesta de la industria ante esta primera pared ha sido elegante en su sencillez: "De acuerdo, el entrenamiento está llegando a un punto de saturación. Pero ahora tenemos modelos que razonan en tiempo real —los thinking models— que mejoran sus respuestas gastando más cómputo en el momento de la inferencia, no en el entrenamiento." Es la tesis de OpenAI con su serie O, de Anthropic con su extended thinking, o de DeepSeek con R1, sólo por mencionar tres ejemplos de la tendencia. Y funciona: los resultados en matemáticas, código y razonamiento complejo mejoran de forma real cuando el modelo "piensa más tiempo".
El problema es el precio. Una consulta procesada por un thinking model consume entre diez y cien veces más cómputo que una consulta de chat convencional, en una horquilla que los estudios más rigurosos sitúan entre 10x y 74x en el benchmark AIME. No es un incremento marginal. Es un cambio de orden de magnitud. Y si la inferencia es (como debería ser, si la IA termina por ser un éxito) el grueso del negocio futuro, lo que estamos haciendo es sustituir un muro de costes de entrenamiento por un muro de costes de inferencia. La factura cambia de sitio, pero no desaparece. Ni hay quien se la salte.
Analistas como Brookfield proyectan que la inferencia reclamará el 75% de la demanda energética total de IA para 2030. Si a eso le sumamos que los modelos de razonamiento generan respuestas cientos de veces más largas que los convencionales (porque "sobrepiensan" incluso las tareas simples, como ha documentado Apple Machine Learning Research), el consumo de recursos escala de una forma que invalida las proyecciones de abaratamiento que la industria (o los financieros que la controlan) lleva dos años vendiendo.
Es el segundo muro. Y tampoco hay quien lo salte.
La trampa que se cierra sola
Aquí es donde la cosa se pone fea de verdad.
La cuantización, un término para iniciados que significa reducir la precisión numérica con la que opera un modelo, de 16 bits a 4, a 3, o incluso a 1, se concibió como la vía de escape. Si no puedes abaratar el entrenamiento, al menos abarata la ejecución. Y para tareas simples funciona. Un modelo cuantizado a 4 bits puede resumir textos, clasificar correos o mantener una conversación con un acierto que te cuesta distinguir del modelo completo.
Pero los thinking models necesitan más precisión, no menos. El razonamiento multi-paso — justo la capacidad que justifica el sobrecoste de la inferencia— es lo primero que se degrada cuando cuantizas. Los datos de Li et al. muestran hasta un 32% de caída de exactitud en tareas de razonamiento matemático con cuantización agresiva sobre modelos "Llama-3". Cierto es que ese dato es el peor caso documentado, pero su media está en torno al 11%, y su trabajo posterior eleva la caída hasta el 70% en configuraciones extremas. No es un efecto marginal. Es la diferencia entre un modelo que resuelve un problema y uno que alucina la solución.
Es decir: cuantizas para abaratar, pero destruyes lo único que justifica el coste. Y a ver quién se salta el tercer muro.
Tres puertas, todas tapiadas
A nadie en esta industria le conviene ser el primero en decirlo en voz alta, pero los tres caminos para sostener el modelo de negocio están bloqueados. Escalar el entrenamiento tiene rendimientos decrecientes demostrados: cada cien veces más de inversión compra una mejora que a un usuario normal le cuesta percibir. Mejorar por la vía de la inferencia con modelos que razonan funciona técnicamente, pero multiplica los costes por un factor que hace inviable el abaratamiento prometido. Y cuantizar para abaratar destruye precisamente la capacidad que justifica la existencia de los modelos más avanzados. Como argumenté en "¿Dónde está la bolita?", a nadie en la cadena le conviene pararse a pensar si hay bolita de verdad.
Y sin embargo, para ti, probablemente funcione
Sería deshonesto no reconocer una cosa: para la inmensa mayoría de los usos empresariales, el problema no existe. Un modelo eficiente ejecutándose en local — cuantizado, sí, pero para tareas que no exigen razonamiento profundo— cubre de sobra el 80% del trabajo: resumir documentos, clasificar información, generar borradores, automatizar lo repetitivo. No necesitas un modelo de frontera para contestar correos. Si eres un CTO que ha desplegado IA en su empresa y te funciona, enhorabuena. Te funciona. Pero eso es exactamente lo que hace el trilema más devastador, no menos.
Para complicar aún más la valoración, Nvidia acaba de poner sobre la mesa una caja de sobremesa con procesador Blackwell y 128 gigabytes de memoria unificada, capaz de ejecutar un modelo de 120.000 millones de parámetros sin pasar por la nube. O lo que es lo mismo: sin necesitar los carísimos centros de datos en los que sus clientes instalan a mansalva esos mismos procesadores. Sorprendente, ¿verdad? Aunque conviene leer la letra pequeña: ese modelo corre ahí porque está cuantizado a 4 bits. Lo que cabe en la mochila no es un modelo de frontera, es el "good enough" del que venimos hablando: brillante para el 80% de las tareas, y enfocado a usuarios a quienes no importa que se estrelle contra el tercer muro en el 20% que de verdad exige razonar. El cacharro que parece hacer innecesarios los datacenters resulta ser la mejor prueba de dónde está el límite. Y no debe de ser un disparate tan grande, porque AMD —su rival histórico— ya vende cajas de memoria equivalente a menor precio, y acaba de presentar la suya propia abaratando la de Nvidia en setecientos dólares. Señal elocuente de que los fabricantes de hardware no las tienen todas consigo sobre el futuro de los superdatacenters, y se curan en salud poniendo una vela a Dios y otra al diablo.
Pero es que si el "good enough" cubre el 80% de los casos de uso —y como vimos en "¿Y si la Misión Génesis fuera un inmenso error?", mi hija ya lo confirmó con un modelo chino que no le costaba nada—, entonces los cientos de miles de millones invertidos en infraestructura de frontera se están gastando para servir al 20% restante. Un 20% para el que, como acabamos de ver, no hay camino claro de mejora a coste razonable.
La inversión masiva en datacenters, en GPUs, en modelos cada vez más grandes, descansa sobre la premisa de que la frontera seguirá avanzando y justificará el gasto. Los datos dicen que no. Y cuando la frontera deja de avanzar pero la inversión no se detiene, lo que tienes no es innovación. Es inercia. Inercia con un coste de cientos de miles de millones de dólares.
¿Cuánto tiempo puede la industria más cara de la historia mantener la carrera cuando las tres puertas están tapiadas y lo que de verdad funciona ya cabe en una mochila?
Y la mochila se hará más pequeña a medida que la ley de Moore siga su camino. Quizá la IA termine en una mochila. Quizá termine en un bolsillo.
Lo que no sé es quién va a pagar los cientos de miles de millones necesarios para seguir empujando la frontera cuando la mayor parte del valor ya pueda ejecutarse localmente.
Y esa, más que una pregunta tecnológica, es una pregunta económica.
Este artículo forma parte de una serie iniciada en "¡Menos madera, es la guerra!", que continúa en "¿El final de la barra libre de tokens?", "¿Y si la Misión Génesis fuera un inmenso error?", "¿Dónde está la bolita?", "Del paquete al token y vuelta a empezar", "Invirtiendo en máquinas de escribir", "¿Llegará a tiempo la "Killer App"?", "¿Nos están haciendo un hueco?", "Encuentre las 8 diferencias". Y continuará...
Nuestras últimas novedades
¿Te interesa saber cómo nos adaptamos constantemente a la nueva frontera digital?
Corporate news
7 de octubre de 2026
Sngular crece un 7,2% en el primer semestre de 2026
Estrategia
6 de octubre de 2026
Nvidia: cuatro, negro, par y falta
Estrategia
29 de septiembre de 2026
¿Le darías tu cartera a Zuckerberg?