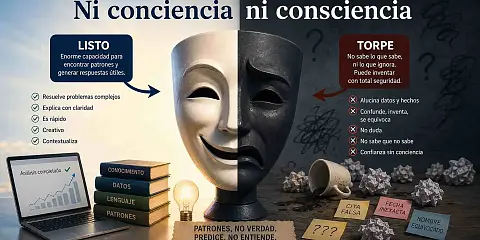
Ni conciencia ni consciencia
14 de julio de 2026
Hace unos día le pedí a la IA que uso habitualmente que me escribiera una "bio" que me pedían para una conferencia. Lo hizo con soltura: cargo actual, trayectoria, publicaciones, tono profesional sin pasarse de corporativo. Todo correcto, salvo un pequeño detalle sin importancia: que se inventó mi apellido. No uno parecido, ni una variante fonética, sino uno completamente distinto. Y lo hizo con la misma aplastante seguridad con que acertó en todo lo demás. Ninguna pausa, ninguna duda, ningún "no estoy seguro de esto" antes de atizarme un "Villanueva" que suena bien pero no es mi "de Cabo". La misma confianza para lo que "sabía" que para lo que aportaba por su cuenta. Como si le diera exactamente igual.
Y es que le da exactamente igual. Porque un modelo de lenguaje no distingue entre lo que sabe y lo que inventa. No puede. No por maldad, sino porque no está en su diseño.
Llevamos meses hablando en esta serie de los costes, las burbujas, los trilemas y las ausencias que rodean a la inteligencia artificial. Todo muy interesante, pero también muy macro. Así que hoy quiero hablar de algo más básico y más incómodo: de lo que estos sistemas no son ni serán mientras sigan funcionando como funcionan. Y el título juega deliberadamente con dos palabras que en español suenan parecido pero significan cosas muy distintas, porque intenta resumir las dos mayores limitaciones de esta tecnología a la que nos acercamos cada día como si fuera un oráculo omnisciente.
Hola, ¿hay alguien ahí?
Un modelo de lenguaje grande — un LLM — no entiende nada de lo que dice. Calcula, para cada fragmento de texto que ha recibido, cuál es la siguiente secuencia de palabras más probable. No tiene un modelo del mundo. No sabe qué es la gravedad, ni qué significa un contrato, ni quién soy yo. Tiene patrones estadísticos extraídos de billones de textos, y con ellos genera secuencias que, la mayoría de las veces, resultan coherentes. Pero coherente no es lo mismo que correcto. Y la distancia entre ambas cosas depende del terreno que pises.
David Chalmers, el filósofo que acuñó el "problema difícil de la consciencia" y que no es precisamente un escéptico de la inteligencia artificial, estimó la probabilidad de que un LLM actual sea consciente en menos de un diez por ciento. Entre las seis razones por las que lo justifica está que les falta un modelo del mundo y un modelo de sí mismos. No saben lo que saben, no saben lo que ignoran, y no tienen representación alguna de su propio procesamiento. Es difícil ser consciente de algo cuando no hay nadie dentro que pueda serlo. Jamás escucharás a un LLM decir que sólo sabe que no sabe nada.
Esto ya lo exploré cuando hablé de la "killer app": en un lenguaje de programación, donde cada instrucción tiene un significado único y el resultado es verificable de forma binaria — compila o no compila —, "probable" y "correcto" casi se solapan. Pero en cuanto pasas al lenguaje humano, con sus ambigüedades, sus ironías, sus sobreentendidos y su dependencia del contexto, la distancia se abre. Y cuanto más sutil es el ámbito — derecho, medicina, negociación, investigación — mayor es esa distancia.
Lo que quiero añadir hoy es por qué eso no tiene arreglo dentro del paradigma actual. En septiembre de 2025, la propia OpenAI publicó un paper titulado "Why Language Models Hallucinate" en el que reconocía que el entrenamiento por predicción del siguiente token y los benchmarks que se usan para evaluar a los modelos premian la confianza al responder frente a la honestidad al decir "no lo sé". Leído con calma, lo que dice OpenAI es devastador: el sistema está diseñado para adivinar con aplomo, y los métodos con que medimos su calidad refuerzan ese comportamiento. La alucinación no es un defecto que se arreglará con la siguiente versión. Es una propiedad inherente a su "arquitectura mental".
Un dato que lo pone en perspectiva: un benchmark de 2026 sobre 37 modelos documentó tasas de alucinación que oscilan entre el 15% y el 52% según el modelo. En consultas jurídicas especializadas, Stanford midió tasas de entre el 69% y el 88%. No estamos hablando de errores marginales. Estamos hablando de que, según el dominio, el sistema fabrica entre una de cada seis y nueve de cada diez respuestas.
Especialistas que no saben de qué saben
A alguien se le ocurrió que la solución era organizar el modelo internamente en "áreas de especialización" (ahora los llamamos "Mixture of Experts"). Una idea que suena bien pero no resuelve nada fundamental. En un MoE, el modelo se divide en sub-redes, y un router decide cuál de ellas se hace cargo de cada consulta. Suena a un hospital con departamentos de cardiología y traumatología. Pero los "expertos" no son dominios de conocimiento sino clusters estadísticos que emergieron durante el entrenamiento. El router no "sabe" qué experto es apropiado; aprendió qué sub-red produce menor error para según qué tipo de patrones de entrada. Es especialización sin especialistas. Un cardiólogo humano sabe que no sabe de huesos. Un "experto" MoE no sabe ni qué es un experto, ni en qué.
Ni remordimiento ni duda
Y aquí entra la segunda palabra. Un LLM no tiene conciencia, en el sentido moral del término, de lo que produce. No distingue entre verdad y ficción porque no posee el concepto de verdad. No puede dudar, porque dudar requiere saber que podrías estar equivocado, y eso requiere un modelo de la realidad contra el que contrastar lo que vas a decir. Cuando yo me invento algo, lo sé. Puedo elegir decirlo o callarme. Cuando un LLM fabrica tu apellido, tu historial clínico o una cita judicial, no hay elección ni ocultación: simplemente no hay mecanismo interno que distinga ese output de uno correcto. La confianza es uniforme. Siempre "lo está petando". Al menos, en su opinión. En esa opinión de la que también carece.
Esto tiene consecuencias que ya no son teóricas. En abril de 2026, Sullivan & Cromwell — uno de los bufetes más prestigiosos del planeta, con socios que facturan a más de 2.000 dólares la hora — tuvo que pedir disculpas a un juez de quiebras en Nueva York por un escrito plagado de citas inventadas por IA. Tres páginas de correcciones, a espacio simple. Semanas después, en Mississippi, el juez Aycock paralizó un juicio porque ambas partes habían presentado escritos con referencias fabricadas. Cuatro abogados sancionados y el juicio cancelado. A fecha de hoy, un investigador de HEC París de apellido divertido (Charlotin) ha documentado más de 1.500 casos de alucinaciones en escritos judiciales en todo el mundo. Solo en los primeros meses de 2026, las sanciones sumaron más de 145.000 dólares, récord histórico.
Y no es solo en el peculiar y siempre matizado mundo del derecho. En mayo de 2026, el autor de un libro titulado, para mayor disparate, "The Future of Truth: How AI Reshapes Reality", tuvo que admitir que contenía más de media docena de citas inventadas por las mismas herramientas de IA que usó para investigarlo. El problema no estuvo en la IA, sino en que los humanos a quienes se atribuyeron tales citas las leyeron y dijeron que jamás habían dicho eso. ¿Puedes imaginar una situación más irónica?
La procesión de parches
La industria, naturalmente, no se ha quedado quieta. RAG (el acrónimo por Retrieval Augmented Generation) dota a los modelos de acceso a documentos externos para que "busquen" antes de responder. Reduce las alucinaciones factuales, sí, pero el modelo sigue sin saber si lo que encontró es relevante o si lo está interpretando bien. Es ponerle un GPS a quien no sabe conducir. El extended thinking, del que ya hablé en el artículo sobre el trilema por su impacto en costes, tiene además un problema epistémico: ¿produce comprensión, o simplemente genera secuencias más largas de tokens probables? La investigación de Apple Machine Learning Research sobre "The illusion of thinking" afloró la idea de "overthinking", que apunta a lo segundo: el modelo no sabe cuándo ha pensado suficiente porque no tiene criterio de verdad. Y el tool use — que el modelo pueda llamar a calculadoras, bases de datos, APIs externas — es interesante precisamente por lo que revela: necesitas muletas externas porque no puedes fiarte del sistema por sí solo. Es una confesión arquitectónica disfrazada de funcionalidad.
Juez y parte
Hay un viejo principio en cualquier relación contractual: la interpretación de un acuerdo nunca debe quedar al arbitrio de una sola de las partes. Es sentido común jurídico, pero también sentido común a secas. Y es exactamente lo que se viola cada vez que interactúas con un LLM.
El modelo decide qué responde. Decide cuántos tokens gasta en "pensarlo", y tú pagas esa factura sin poder auditar el proceso. Decide, de hecho, si lo que te dice es fiable o no, pero sin decírtelo, porque no tiene acceso a esa información. Fija las reglas, ejecuta el trabajo, evalúa su propia calidad y pasa la factura. La otra parte (que eres tú) solo puede aceptar o rechazar el resultado completo, sin visibilidad sobre nada intermedio. Pero pagando, claro.
Y aquí está la vuelta de tuerca: esa asimetría no existe porque alguien quiera engañarte (aunque la opacidad comercial ayuda). Existe porque el propio sistema no puede explicar por qué ha hecho lo que ha hecho. No es que te oculte el razonamiento; es que no hay razonamiento que ocultar, solo una cascada de operaciones matemáticas que ni sus creadores pueden interpretar. La interpretación del contrato queda al arbitrio de una parte que ni siquiera sabe que está interpretando nada.
Y sin embargo...
Sería deshonesto no repetir lo que ya dije en artículos anteriores: para la inmensa mayoría de los usos, funciona. Resumir un documento, clasificar un correo, generar un borrador, mantener una conversación, escribir código rutinario... para el 80% de las tareas, un LLM es una herramienta extraordinariamente útil. Pero ese 80% es precisamente el terreno donde "probable" y "correcto" se solapan lo suficiente. El problema está en el 20% restante: las tareas donde la precisión importa, donde un error tiene consecuencias, donde necesitas poder confiar en el output sin verificar cada línea. Que es, ¡vaya por Dios!, el terreno donde la industria nos dice que está el verdadero valor transformador.
No es casualidad que Yann LeCun, premio Turing y uno de los padres del "deep learning", haya dejado Meta para fundar AMI Labs con más de mil millones de financiación, apostando por lo que él llama "world models", y que son sistemas que aprenden del mundo físico en vez de predecir palabras. LeCun no ha diagnosticado un problema de rendimiento. Ha diagnosticado un problema de paradigma. Y ha decidido que la solución no pasa por parchear este, sino por construir otro.
Un vídeo de Jordi Segués que circula estos días muestra a una IA respondiendo a qué es lo que más admira de la humanidad. La respuesta sobrecoge: dice que somos la única especie que coopera a gran escala con sus muertos, que casi nada de lo que sabe un humano lo descubrió él, que cuando le hablas conversas con "un eco organizado de millones de voces, muchas de ellas apagadas hace tiempo". No sólo es bonito sino también, sin que la máquina lo sepa, una descripción técnicamente exacta de lo que ella misma es: patrones estadísticos extraídos de textos escritos por personas que, en muchos casos, ya no viven. La IA lo dice como metáfora y resulta que es literal. Eso es exactamente lo que pasa cuando confundes elocuencia con comprensión.
Lo que debería preocuparte
Si las limitaciones son arquitectónicas y no de escala, escalar no las resuelve. Y si escalar no las resuelve, buena parte de los cientos de miles de millones que se están invirtiendo en hacer estos modelos más grandes, más rápidos y más caros de operar va destinada a amplificar un mecanismo que, por diseño, no puede garantizar la veracidad de lo que produce.
Para un directivo, la pregunta no es si la IA le es útil, que probablemente lo sea. La pregunta es si está tomando decisiones de inversión, de estrategia o de transformación organizativa asumiendo que esta tecnología es algo que, por arquitectura, no es: un sistema que entiende lo que dice.
Ni consciencia para saber lo que sabe, ni conciencia para que le importe lo que no sabe. Tal vez la siguiente pregunta sea: ¿Y si el problema fuera que no somos conscientes de que nuestra IA favorita no tiene conciencia?
Este artículo forma parte de una serie iniciada en "¡Menos madera, es la guerra!", que continúa en "¿El final de la barra libre de tokens?", "¿Y si la Misión Génesis fuera un inmenso error?", "¿Dónde está la bolita?", "Del paquete al token y vuelta a empezar", "¿Hemos vuelto a invertir en máquinas de escribir?", "¿Llegará a tiempo la Killer App?", "¿Nos están haciendo un hueco?", "Encuentre las 8 diferencias" y "¿Acabará la IA en una mochila?".
Nuestras últimas novedades
¿Te interesa saber cómo nos adaptamos constantemente a la nueva frontera digital?
Corporate news
7 de octubre de 2026
Sngular crece un 7,2% en el primer semestre de 2026
Estrategia
6 de octubre de 2026
Nvidia: cuatro, negro, par y falta
Estrategia
29 de septiembre de 2026
¿Le darías tu cartera a Zuckerberg?