Yogures y tokens: bienvenidos al confusopolio de la IA
28 de julio de 2026
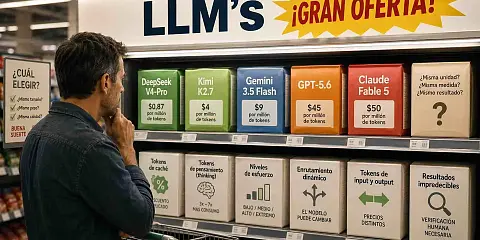
La semana pasada mi mujer me mandó a comprar yogures al Corte Inglés. Como buen viejennial, vengo de una época en la que existían tres tipos de Danone: natural, de chocolate y de caramelo. Te acercabas al lineal, cogías un pack y te ibas a casa. Me planté delante de la nevera y me quedé paralizado. Decenas de marcas. Con grasa o sin grasa. Con azúcar o sin azúcar. Con trozos de fruta o sin trozos. Con lactosa o sin lactosa. Con proteínas añadidas. Con bífidus. Con L-Casei. De soja, de avena, de coco. Kéfir, skyr, quark. Volví a casa sin yogures y con una sensación que cualquier psicólogo conductual reconocería al instante: la parálisis del que sospecha que, elija lo que elija, le están tomando el pelo.
Pues exactamente eso es lo que siento cada vez que miro el precio de un modelo de inteligencia artificial.
El gráfico que no dice lo que crees
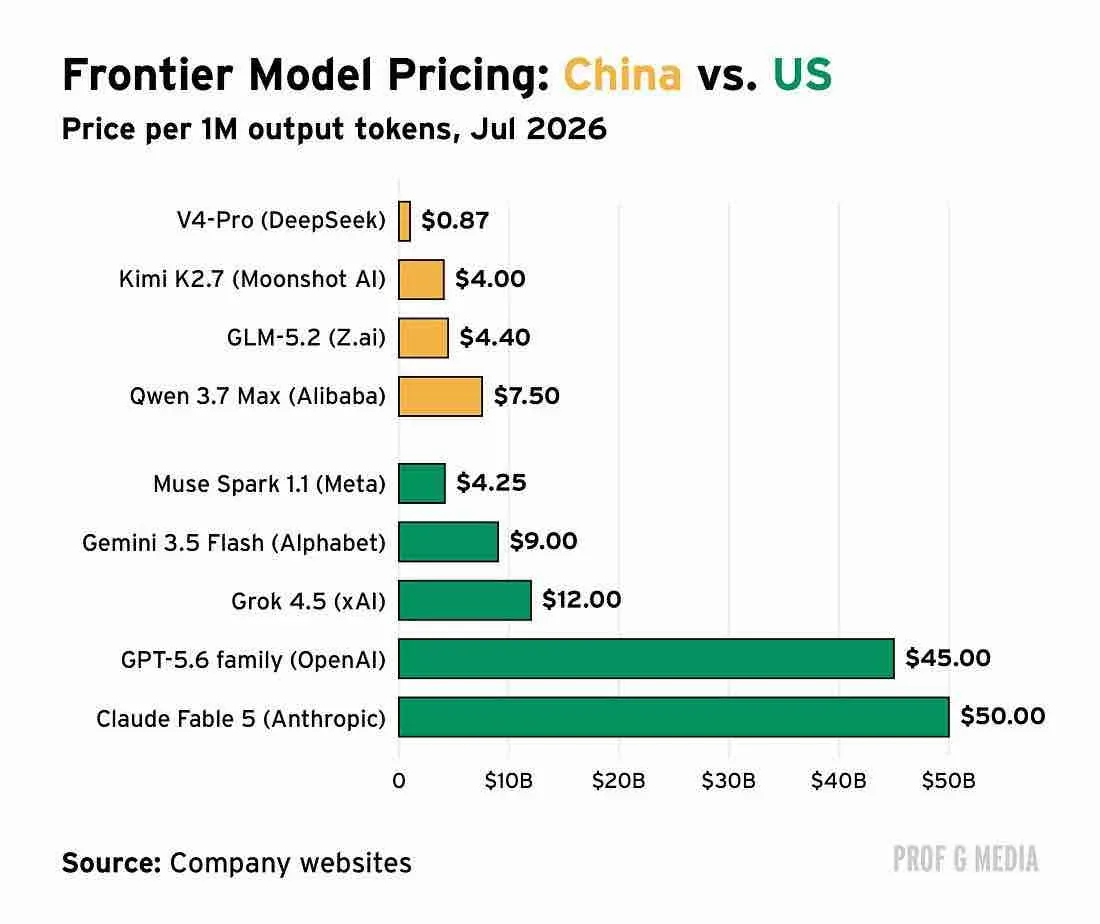
Scott Galloway, que tiene mano para los golpes visuales, publicó hace unos días un gráfico de barras comparando el precio por millón de tokens de output de los principales modelos de frontera en julio de 2026. DeepSeek V4-Pro: 0,87 dólares. Kimi K2.7: 4 dólares. Gemini 3.5 Flash: 9. GPT-5.6: 45. Claude Fable 5: 50. Un arco de 57x entre el más barato y el más caro. Si fuera un lineal de yogures, sería como si el Danone natural costara 80 céntimos y el skyr de proteínas de la misma nevera costara 46 euros.
El gráfico es espectacular. El problema es que no mide lo que crees que mide. Porque el token no es una unidad de medida estándar.
Tres cosas que nadie te cuenta
La primera es que nadie sabe exactamente cómo cuenta los tokens cada proveedor. Cada modelo usa su propio tokenizador (nuevo barbarismo que designa al algoritmo que trocea las palabras en fragmentos procesables). La misma frase puede descomponerse en un número distinto de tokens según el modelo que la procese. "Inteligencia artificial generativa" puede ser tres tokens en un modelo y cinco en otro. Estás comparando precios por unidad, pero la unidad no es la misma. Completa tú mismo la ecuación.
La segunda es que, incluso si los tokens fueran comparables, los modelos consumen cantidades brutalmente distintas para completar la misma tarea. Un paper reciente sobre razonamiento en LLMs (NPPC, publicado por un equipo de Singapore Management University) sometió a varios modelos de frontera a las mismas tareas con los mismos prompts. Resultado: o3-mini generó 110 millones de tokens de output frente a menos de 10 millones de GPT-4o-mini. Misma empresa, misma tarea, mismo prompt. El coste total pasó de 10 dólares a 522 para las mismas preguntas. Un segundo trabajo (FinMaster, coordinado desde Hong Kong Polytechnic) probó lo mismo en benchmarks financieros: o3-mini consumió 16.000 tokens por tarea de contabilidad donde DeepSeek-V3 consumió 2.000. Ocho veces más. Y sus autores dejaron una frase que merece tatuarse: "Un mayor consumo de tokens no se traduce necesariamente en mejor rendimiento."
Y la tercera, que es la que convierte esto en un festival del absurdo: los modelos de razonamiento (los que "piensan" antes de responder y que muchos usamos con el mismo entusiasmo con que hace veinte años comprábamos el Office Professional sin haber abierto jamás el Access) añaden una capa de tokens invisibles que pagas pero no ves. Son los "thinking tokens": según los benchmarks el modelo gasta entre 3 y 7 veces más tokens "pensando" que respondiendo.
Ya que estamos hoy por cuantificar, solo dentro de Claude hay entre cincuenta y cien combinaciones posibles de modelo, nivel de esfuerzo y modo de pensamiento. Un disparate. Y cada combinación consume una cantidad distinta de tokens para la misma pregunta. Opus 4.6, que es un modelo inferior a Opus 4.7, consume en algunos benchmarks más tokens que su sucesor para la misma tarea. Es decir: pagas más por un resultado peor (aunque definir "peor" sería también complicadísimo en según qué campos). Exactamente como si un yogur de marca blanca costara más que el Danone porque el envase fuera más bonito.
El precio que no aparece en ningún gráfico
Pero lo verdaderamente tramposo no es nada de lo anterior. Lo verdaderamente tramposo es lo que pasa cuando el modelo se equivoca.
Si le pides a un modelo barato que revise un contrato y alucina tres cláusulas, necesitas un abogado que verifique el resultado. Si le pides a uno caro que haga lo mismo y acierta a la primera, el coste de verificación es cero. El precio real de una tarea de IA no es precio por token multiplicado por tokens consumidos. Es precio por token, multiplicado por tokens consumidos, multiplicado por número de intentos, multiplicado por el coste de la verificación humana. Y esa última variable (cuánto te cuesta comprobar si el resultado es correcto) no aparece en ningún gráfico de Galloway ni en ninguna página de precios de ningún proveedor. Es invisible. Tan invisible como las alucinaciones que la producen.
Complicado trasladar esto a la metáfora del yogur. Tendría que ser algo así como que el lineal de yogures incluyera en el precio el coste de la visita al médico cuando el que elegiste resulta que tenía la fecha caducada. Pero sin fecha de caducidad impresa.
El confusopolio
Scott Adams, el creador de Dilbert, que se pasó la vida riéndose de las corporaciones disfuncionales, acuñó hace años un término que describe perfectamente esta situación: confusopolio. Era demasiado bueno para que fuera mío, ¿verdad? Un mercado donde los proveedores hacen deliberadamente imposible comparar sus ofertas, para que el cliente no pueda tomar una decisión informada. Las operadoras de telecomunicaciones fueron maestras en esto durante décadas: tarifas con franjas horarias, redondeos al alza, paquetes que combinaban minutos, datos y SMS en proporciones incomparables. Sus herederas espirituales, las eléctricas, nos hacen sudar frío antes de encender un aparato por no saber qué último contrato y banda horaria firmamos cuando nos llamó la última teleoperadora. El objetivo no es ofrecer opciones. Es impedir la comparación.
La industria de la IA ha llevado el modelo a un nivel excelso. Precio distinto para input y output. Ratio diferente entre ambos según el proveedor. Tokens de caché con descuento. Tokens de pensamiento que se facturan aparte. Niveles de esfuerzo que multiplican el consumo. Enrutamiento dinámico que te cambia de modelo sin avisarte. Y todo ello con una unidad de medida (el token) que no es estándar entre proveedores. ¿Alguien da más?
Si un directivo me preguntara ahora mismo cuánto le va a costar la IA de su empresa el año que viene, la respuesta honesta es: no lo sé. Nadie lo sabe. Y los proveedores prefieren que siga siendo así. Es la magia del confusopolio.
La pregunta del yogur
Volví a casa sin yogures porque la sensación de que me estaban tomando el pelo era más fuerte que las ganas de acertar. Con la IA, las empresas no tienen esa opción. Tienen que comprar. Pero podrían al menos exigir lo que cualquier consumidor exige en cualquier otro mercado: una etiqueta que diga claramente qué hay dentro, cuánto pesa y cuánto cuesta por kilo.
Mientras el token siga siendo una unidad opaca, variable y no comparable, estamos comprando yogures sin etiqueta nutricional. Y pagando un precio que solo el fabricante puede calcular. ¿A alguien más le parece que eso tiene un nombre?
Nuestras últimas novedades
¿Te interesa saber cómo nos adaptamos constantemente a la nueva frontera digital?
Corporate news
7 de octubre de 2026
Sngular crece un 7,2% en el primer semestre de 2026
Estrategia
6 de octubre de 2026
Nvidia: cuatro, negro, par y falta
Estrategia
29 de septiembre de 2026
¿Le darías tu cartera a Zuckerberg?